Bewährte Methoden für geführte Fehlersuche, die die MTTR senken
Artikel teilen
Kurze Antwort: Geführte Fehlersuche senkt die MTTR nur, wenn sie auf fünf konkrete Praktiken aufbaut: jede Antwort an die Anlage vor dem Techniker binden, jeden Vorschlag mit einer Quelle belegen, bei fehlender Historie automatisch eskalieren, die Lösung danach erfassen und Eskalationen nach Qualifikation statt nach Verfügbarkeit verteilen. Fehlt eine davon, wird aus einer schnellen Demo ein unzuverlässiges System, sobald es auf mehr als einer Linie läuft.
Eine Demo für geführte Fehlersuche lässt sich leicht beeindruckend gestalten. Sie so zum Laufen zu bringen, dass sie die MTTR über jede Schicht und jede Linie hinweg senkt, innerhalb eines echten Programms für Instandhaltungsmanagement, ist eine andere Aufgabe, und genau darum geht es in diesem Beitrag. KI-gestützte Maschinenfehlersuche beschreibt, was die Fähigkeit an sich ist. Hier geht es darum, was sie auch dann noch trägt, wenn das Team, das den Pilotversuch genehmigt hat, die Zahl sich bewegen sehen will.
Die Lücke zwischen beidem ist konkret, nicht diffus. Ein System, das für einen Techniker in einer Demo gut antwortet, und ein System, dem ein Instandhaltungsleiter werksweit vertraut, unterscheiden sich in genau fünf Punkten, und jeder davon lässt sich testen, bevor Sie sich auf einen Rollout festlegen.
Was macht geführte Fehlersuche zuverlässig genug, um die MTTR zu senken?
Geführte Fehlersuche senkt die MTTR, wenn die gegebene Antwort auf der konkreten Anlage vor dem Techniker beruht, nicht auf einer werksweiten Suche durch alle Handbücher. Das System muss an die eigene Dokumentation und Reparaturhistorie genau dieser Maschine gebunden sein, jeder Vorschlag muss mit einer Quelle belegt und nachprüfbar sein, und es muss sauber eskalieren, sobald die Historie an ihr Ende kommt.
Jeder dieser Punkte ist eine Design-Entscheidung, kein Feature, das sich später ergänzen lässt. Ein System, das auf einer generischen Wissensdatenbank aufbaut, lässt sich zwar auf bessere Daten ausrichten, aber es kann nicht nachträglich ein Konzept von „dieser konkreten Anlage“ entwickeln, wenn genau diese Einheit nicht von Anfang an die Grundlage war.
Warum scheitern die meisten Pilotprojekte für geführte Fehlersuche, bevor sie in die Produktion gehen?
Die meisten Pilotprojekte scheitern, weil ein System, das in der Demo gut antwortet, keinen Mechanismus hat, um zu erkennen, wann es falschliegt, keine Aufzeichnung darüber führt, was der Techniker mit dem Vorschlag gemacht hat, und keinen Verantwortlichen mehr hat, sobald es auf mehr als einer Linie läuft. Laut Fraunhofer-Forschung scheitern 80 Prozent der KI-Projekte beim Skalieren, und die Ursache liegt selten darin, ob das Modell im Test eine gute Antwort liefert.
Das AI Risk Management Framework des NIST benennt diesen Fehlermodus direkt: Ein System, das bei bekannten Eingaben gut funktioniert, hat oft kein definiertes Verhalten für einen Fehler, den es noch nicht gesehen hat, was auf dem Shopfloor eine selbstsichere, falsche Antwort bedeutet, ohne jede Markierung als unsicher. Eine Demo läuft selten lange genug, um diesen Fall zu treffen. Ein Werk, das das System in jeder Schicht einsetzt, trifft ihn in der ersten Woche.
Welche fünf Praktiken unterscheiden produktionsreife geführte Fehlersuche von einer Demo?
Jede Antwort an die Anlage vor dem Techniker binden. Keine werksweite Suche durch alle Handbücher, sondern eine Abfrage, die an die Identität genau dieser Maschine gebunden ist: ihre OEM-Dokumentation, ihre eigene Reparaturhistorie, nichts von einer anderen Linie, die zufällig dieselbe Modellnummer trägt.
Jeden Vorschlag mit einer Quelle belegen. Der Techniker sollte sehen, woher eine Antwort stammt, von welcher Handbuchseite, von welcher früheren Reparatur, damit er sie prüfen kann, statt ihr blind zu vertrauen. Eine Antwort ohne Quelle ist eine Vermutung im selbstsicheren Tonfall.
Bei fehlender Historie automatisch eskalieren. Wenn nichts in der Aufzeichnung diesen Fehler abdeckt, leitet das System an einen zertifizierten Techniker weiter, statt eine plausibel klingende Lösung zu extrapolieren. Eine selbstsichere, falsche Antwort kostet mehr als ein ehrliches „Das kenne ich nicht“.
Die Lösung erfassen, nicht nur die Frage. Was der Techniker getan hat, wird zur Historie für den nächsten Techniker. Ein System, das die Frage und den Vorschlag protokolliert, aber nie das Ergebnis, summiert sich nie auf. Es beantwortet dieselbe Frage jedes Mal wieder bei null.
Eskalationen nach Qualifikation statt nach Verfügbarkeit verteilen. Den Fehler an denjenigen zu schicken, der gerade frei ist, statt an denjenigen, der für diese Anlage zertifiziert ist, verschiebt den Engpass nur um eine Person weiter, und der Techniker, der ihn übernimmt, sucht jetzt ebenfalls blind.
Wie misst man, ob geführte Fehlersuche die MTTR tatsächlich senkt?
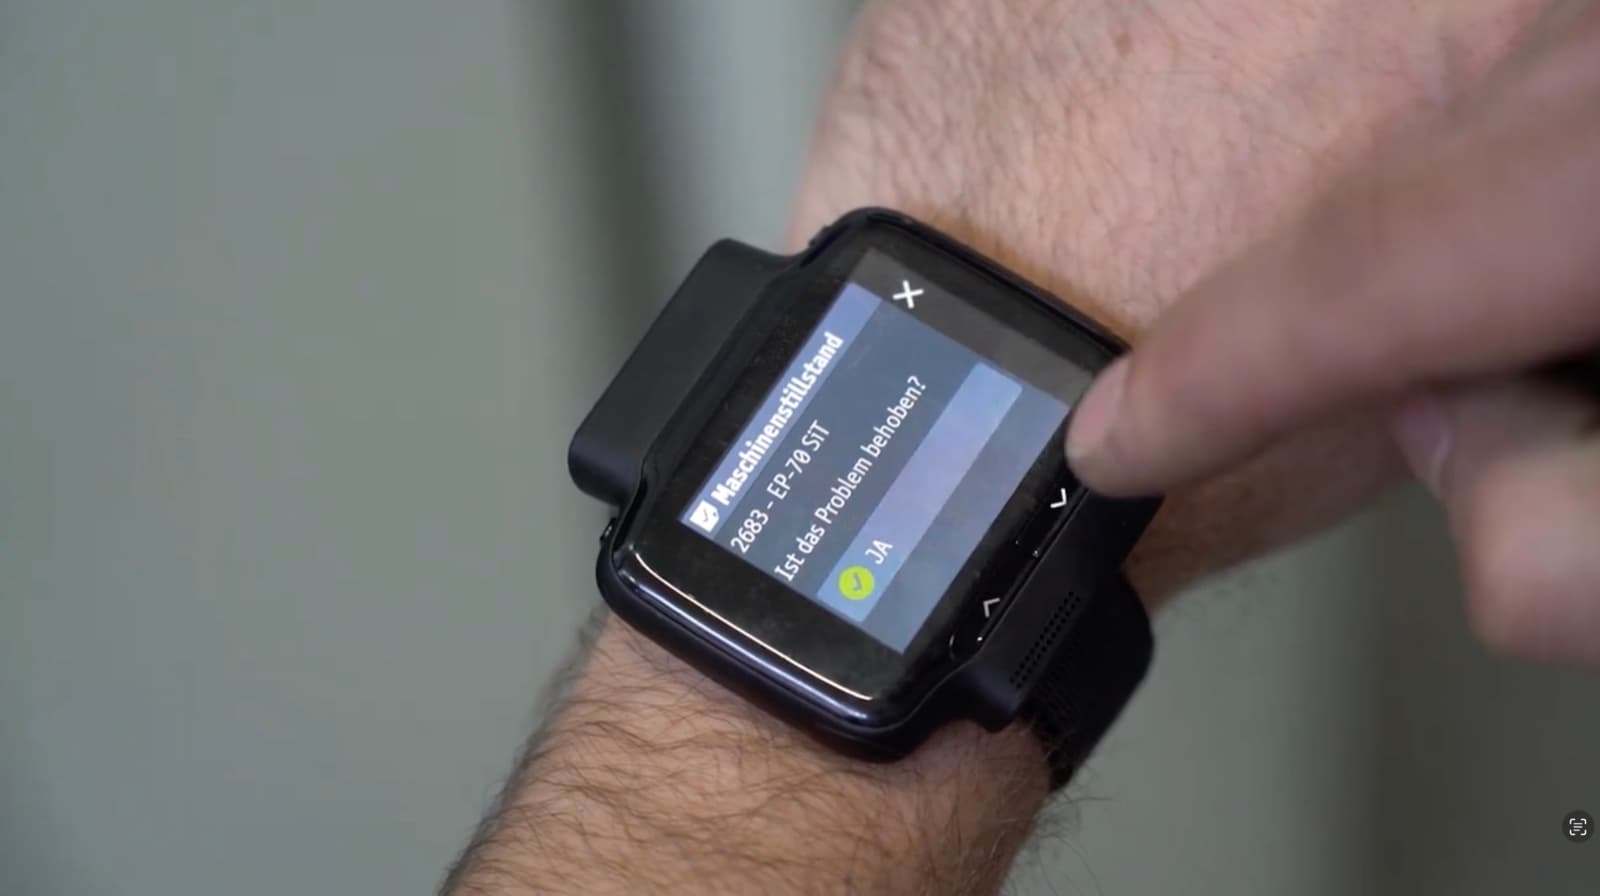
Messen Sie die Zeit von Alarm bis Lösung gegen eine Vorher-Nachher-Baseline an derselben Anlage, nicht gegen einen Werksdurchschnitt. So aufgebaute geführte Fehlersuche läuft bereits produktiv bei einem großen Automobilhersteller und bringt Fehlerhistorie und Reparaturhinweise direkt an den Ort des Ausfalls, statt sie als Nachschlagedokument irgendwo suchen zu lassen.
Plattformweite Daten bestätigen dasselbe Muster: Kunden haben 1,2 Mio. Euro an jährlich vermiedenen Stillstandskosten aus einem einzigen Instandhaltungs-Use-Case in einem Werk gemessen, und der Go-live auf einer ersten Linie dauert typischerweise zwei Wochen, mit messbarer Wirkung innerhalb von 30 Tagen. Zeigt ein Pilotprojekt in diesem Zeitfenster keine Bewegung bei der Zeit von Alarm bis Lösung, liegt die Ursache meist bei einer der fünf Praktiken oben, am häufigsten beim fehlenden Eskalationspfad oder der fehlenden Rückmeldung der Lösung.
Was unterscheidet das von einem generischen KI-Chatbot, der auf Ihre Handbücher losgelassen wird?
Ein generischer Chatbot antwortet aus welchen Dokumenten auch immer er bekommen hat, ohne jedes Konzept davon, welche konkrete Maschine fragt oder ob die Antwort aktuell ist. KI-Governance in der Fertigung macht daraus ein System, auf das sich ein Werksleiter verlassen kann: Freigabe, bevor etwas das Gerät eines Mitarbeiters erreicht, eine Aufzeichnung dessen, was gelaufen ist, und ein Mensch, der eingreifen kann.
ISO 42001 legt fest, was ein gesteuertes KI-Managementsystem umfassen sollte, und die Praktiken in diesem Beitrag sind die instandhaltungsspezifische Version derselben Disziplin: das System auf das begrenzen, was es weiß, seine Begründung nachprüfbar machen und es nie über den Rand seiner eigenen Daten hinaus antworten lassen.
Häufig gestellte Fragen
Ersetzt geführte Fehlersuche das Urteilsvermögen eines Technikers?
Nein. Es grenzt ein, worauf der Techniker schaut, und zeigt die relevanteste frühere Lösung aus der Historie genau dieser Anlage, aber der Techniker entscheidet weiterhin selbst, was zu tun ist, und kann den Vorschlag jederzeit überstimmen. Die Aufgabe des Systems ist es, die Zeit bis zu einem korrekten Urteil zu verkürzen, nicht die Person zu ersetzen, die es fällt.
Was passiert, wenn das System die Antwort nicht kennt?
Es sollte das offen sagen und an einen zertifizierten Techniker eskalieren, statt zu raten. Ein System, das immer eine Antwort liefert, auch für einen Fehler ohne Historie, untergräbt das Vertrauen beim ersten selbstsicheren Irrtum, und eine schlechte, selbstsichere Antwort macht ein Dutzend guter wieder zunichte.
Benötigen wir eine umfangreiche Reparaturhistorie, damit das funktioniert?
Das hilft, aber Sie benötigen keine jahrelangen Daten, um zu starten. Eine neue Einführung beginnt mit der vorhandenen OEM-Dokumentation und baut danach mit jedem gelösten Alarm echte Reparaturhistorie auf, sodass die Anlage mit den häufigsten Fehlern schon innerhalb der ersten Wochen echten Nutzen bringt, nicht erst nach Jahren.
Lässt sich das auf unseren bestehenden CMMS-Daten aufsetzen?
Ja. Das Anlagenregister und die Arbeitsauftragshistorie können genau so in SAP PM, Maximo oder Infor EAM bleiben, wie sie heute sind. Geführte Fehlersuche liest aus diesem bestehenden Datensatz über die Anlagen-ID, statt eine separate Datenmigration oder ein paralleles System vorauszusetzen, bevor überhaupt etwas beantwortet werden kann.
Woher wissen wir, dass das System dauerhaft innerhalb seiner Grenzen bleibt?
Jeder Vorschlag bleibt mit Quelle versehen und protokolliert, sodass eine Überprüfung dessen, was das System empfohlen hat, ein Berichtsabruf ist, keine Ermittlung. Wenn die einer Antwort beigefügte Quelle keinen Sinn mehr ergibt, ist das das Signal, dass der Geltungsbereich abgedriftet ist und überprüft werden muss.
Bereit zu sehen, wie geführte Fehlersuche an Ihrer schwächsten Anlage läuft? Workerbase-Demo anfragen.